【2026年8月】衛星データ利活用に関する論文とニュースをピックアップ!
2026年8月に公開された衛星データの利活用に関する論文の中でも宙畑編集部が気になったものをピックアップしました。
2026年8月に公開された衛星データの利活用に関する論文の中でも宙畑編集部が気になったものをピックアップしました。
・High-resolution monthly estimation of disturbance-induced tropical forest carbon flux in the state of Rondônia, Brazilian Amazon
(雲を透過して観測できるSentinel-1 SARと深層学習モデルU-Netで森林攪乱を月次10m解像度で検出し、カーボンブックキーピングモデルで炭素フラックスを推定する枠組みを提案する)・CalFireSegNet: a lightweight hybrid attention–transformer network for post-wildfire building footprint change analysis using high-resolution satellite imagery
(カリフォルニアの山火事被災地を対象に、高解像度衛星画像から建物フットプリントをセマンティックセグメンテーションで抽出し、火災前後のマスクの差分から建物損失領域を検出する軽量ハイブリッドモデル「CalFireSegNet」を提案、精度98.45%とmIoU94.35%というトップクラスの性能、かつ高速推論を実現した)・CrisiSense-RAG: Crisis sensing multimodal retrieval-augmented generation for rapid disaster impact assessment
(ハリケーン・ハーヴェイ(2017年、米ヒューストン)を対象に、災害ピーク時のSNS投稿・緊急通報と数日後に撮られる航空画像という時間的にズレた情報を、そのズレを前提にして統合するマルチモーダルRAG「CrisiSense-RAG」を提案する)・TOWARDS A SATELLITE IMAGE MANIPULATION AND DEEPFAKE LOCALIZATION BENCHMARK DATASET
(生成AIによる衛星画像の改ざん・ディープフェイクを対象に、改ざん領域を示す正解マスクと地理参照 / 取得メタデータを備えたベンチマークデータセット「fmow-fake-small」を提案する)
宙畑の新連載「#MonthlySatDataNews」では、前月に公開された衛星データの利活用に関する論文やニュースをピックアップして紹介します。
実は、本記事を制作するために、これは!と思った論文やニュースをX(旧Twitter)上で「#MonthlySatDataNews」「#衛星論文」をつけて備忘録として宙畑編集部メンバーが投稿していました。宙畑読者のみなさまも是非ご参加いただけますと幸いです。
それではさっそく2026年8月の論文を紹介します。
High-resolution monthly estimation of disturbance-induced tropical forest carbon flux in the state of Rondônia, Brazilian Amazon
【どういう論文?】
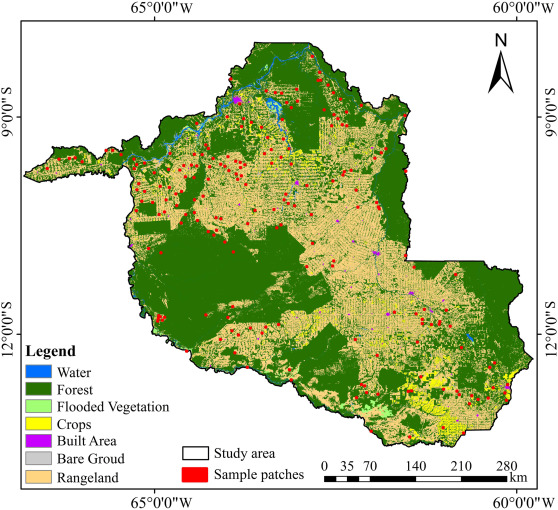
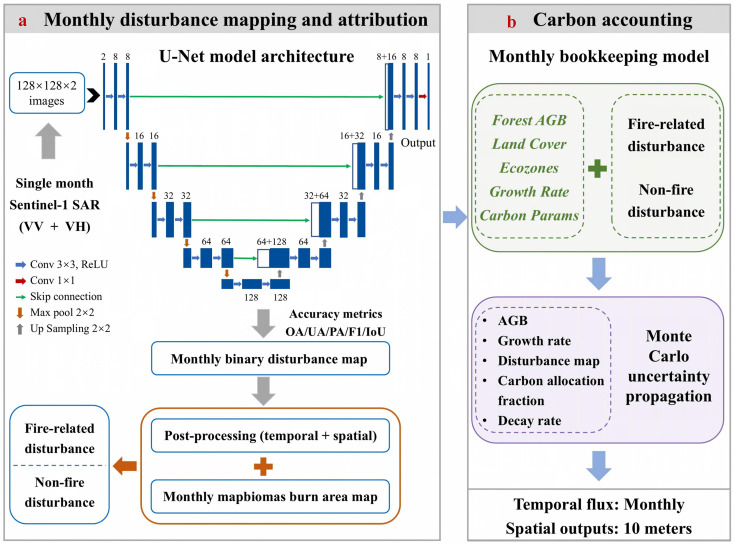
・本論文は、ブラジル・アマゾンのロンドニア州を対象に、雲を透過して観測できるSentinel-1 SAR(レーダー衛星)と深層学習モデルU-Net(画像のどこに何があるかを塗り分けるAI)で森林攪乱(伐採・火災などによる森林へのダメージ)を月次10m解像度で検出し、カーボンブックキーピングモデル(森の炭素の出入りを帳簿のように記録する会計モデル)で炭素フラックス(排出量と吸収量の差し引き)を推定する枠組みを提案する
・従来は年1回30m単位でしか把握できなかった炭素の出入りを月次10m単位で可視化し、2018〜2021年のロンドニア州が正味7.59±2.36 Tg C(テラグラム炭素=100万トン単位)の炭素源(吸収より排出が多い状態)であり続けたことを明らかにした
【技術や方法のポイントはどこ?】
◾️先行研究の課題
①炭素会計(集計)が年1回の大まかな単位でしかできない
・既存のカーボンブックキーピングモデルは年次30m以上の解像度が主流で、乾季に集中する排出ピークや小規模な伐採が見えない
・見逃した攪乱が積み重なると、REDD+(森林保全に資金を出す国際枠組み)や炭素クレジット市場の検証で隠れた炭素負債になる
②光学衛星は雲に遮られる
・LandsatやSentinel-2などの光学衛星(通常のカメラのように太陽光を捉える衛星)は、雲の多い熱帯では観測できない期間が長い
・雲を透過できるSARを使う従来手法は、閾値(この値を超えたら攪乱とみなす基準)を固定するため地域差に弱く、境界が曖昧な攪乱や小さな攪乱を見逃しやすい
③排出だけ数えて森の回復による吸収を無視している
・多くの研究は「攪乱面積×排出係数」の掛け算で排出量を見積もるが、攪乱後に森が再成長して炭素を吸収し直す分(熱帯林では20年で最大225 Mg C/ha)を計上しない、片側だけの帳簿になっている
◾️本研究のアプローチ
①月次攪乱マッピング(U-Net × Sentinel-1 SAR)
・Sentinel-1の月次レーダー画像(VV・VH偏波=電波の送受信方向が異なる2種類の画像)をU-Netに入力し、10m解像度(車1台が識別できる細かさ)で各ピクセルが攪乱されたかを判定
・同じ場所が複数月で検出された場合は最初の月だけを採用し、Mapbiomasの焼失域データ(火災跡地の地図)と重ねて「火災」か「非火災(伐採など)」かに仕分ける
・雲に遮られず毎月攪乱を捉えられるため、季節ごとの排出変動を追えるようになる
②時空間カーボンブックキーピングモデル
・攪乱が起きた炭素を「燃えて即座に放出される分」と「伐採残渣や木材製品としてゆっくり分解される分」に振り分け、月ごとの排出量を計算
・攪乱後は森の回復段階に応じた成長率で、月ごとの吸収量も計算する
③モンテカルロ法による不確実性評価
・バイオマス量 / 成長率 / 攪乱検出精度などのばらつきを考慮してモデルを200回反復計算し、推定値に「±」の信頼幅を付与、政策判断や炭素市場での利用に耐える透明性を確保する
◾️データセット
・Sentinel-1 SAR(2018〜2021年、10m): 月次攪乱検出のメイン入力
・Mapbiomas焼失域データ(2018〜2021年、30m→10m): 攪乱の火災/非火災の仕分け
・補助データ: 森林地上部バイオマス(2017年、10m。攪乱前に森がどれだけ炭素を蓄えていたかの基準値)、2021年土地被覆(解析対象を森林に限定)、CHIRPS降水量(森の成長率の算出根拠)
◾️技術的特徴(U-Net)
・画像を段階的に縮小して特徴を捉え、元の解像度に戻しながら細部を復元するという、一度全体を俯瞰してから細部を描き直す構造で、攪乱の形状と境界を同時に捉える
・Planetの3m解像度画像を人手で判読した正解付きパッチ200枚を用意し、151枚を学習、25枚をパラメータ調整、24枚を独立検証に使用した
https://www.sciencedirect.com/science/article/pii/S2197562026001120
【議論の内容・結果は?】
◾️検証結果の概要
・攪乱検出はOA(全体の正答率)0.92〜0.95の高精度を達成し、2018〜2021年のロンドニア州は正味7.59±2.36 Tg Cレベルの炭素源であったことが示された
◾️詳細
①攪乱マップは信頼できるか(2段階の精度検証と既存データとの突き合わせ)
[AIモデル自体の精度]
・学習に使わなかった24枚の画像で答え合わせした結果、OA(全ピクセルのうち正しく判定できた割合)=0.92、F1スコア(攪乱の「見逃し」と「誤検出」の少なさを1つにまとめた指標。1に近いほど良い)=0.77となった
[完成した月次マップの精度]
・400km²超の検証エリア4か所で、Planet衛星の3m解像度画像を人が目視判読した正解と比較し、OA=0.95、F1=0.78であった
[既存データとの突き合わせ]
・4年間の総攪乱面積5791.57km²は、ブラジル国立宇宙研究所の公式森林伐採統計INPE PRODES(5519.00km²)とほぼ一致
・年ごとの増減の傾向も、PRODESおよび米国の全球森林損失データHansen GFCと強い正の相関(相関係数0.74、0.90)
https://www.sciencedirect.com/science/article/pii/S2197562026001120
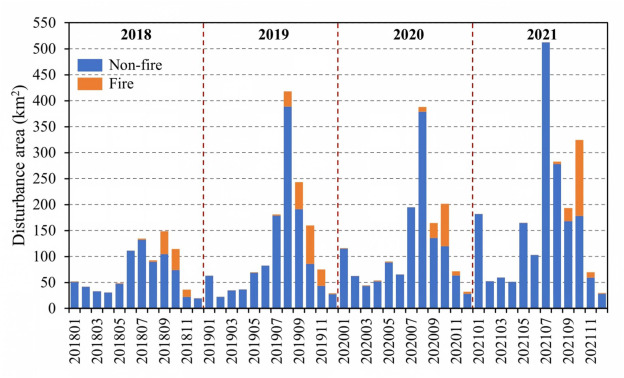
②攪乱は乾季後期に集中する
・非火災攪乱が全体の約9割(5157.17km²)を占め、乾季(5〜10月)にピーク、火災攪乱は乾季後期に急増し、2021年10月に146.44km²と最大
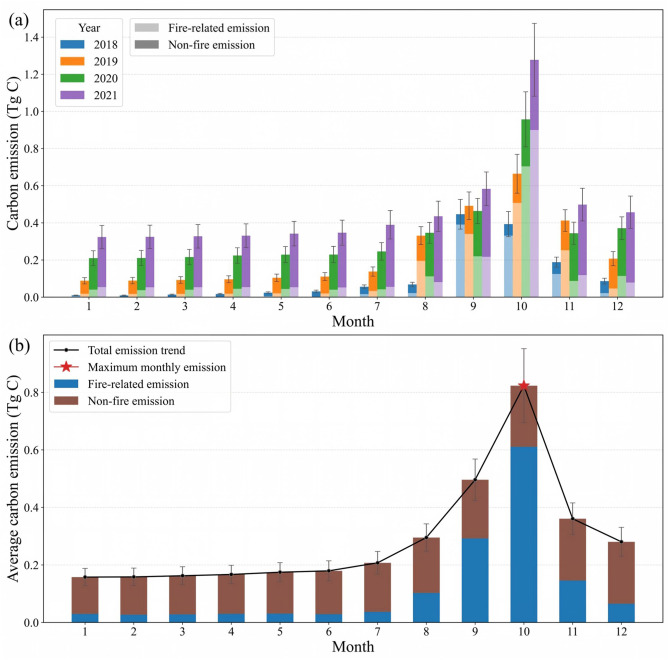
③炭素排出は年々増加し、遅延排出が上乗せされる
・年間排出量は、2018年の1.34±0.20 Tg Cから2021年の5.64±0.92 Tg Cへ4倍以上に増加、乾季の月平均排出(約0.39 Tg C)は非乾季の約2.1倍となっている
・さらに、攪乱面積が小さい月でも排出が大きくなる月があり、過去の攪乱による残存バイオマスの分解排出(遅延排出)が上乗せされている
https://www.sciencedirect.com/science/article/pii/S2197562026001120
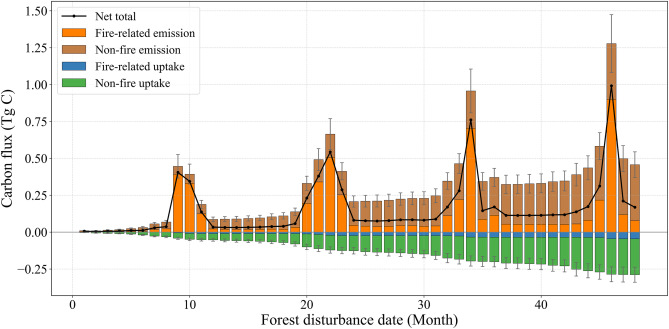
④森の回復は排出を相殺できず、正味の炭素源に
・非火災由来の累積排出8.15±1.86 Tg Cは火災由来の5.71±0.93 Tg Cの約1.4倍、再成長による吸収は合計6.26 Tg Cにとどまり、正味7.59±2.36 Tg Cの排出超過となった
https://www.sciencedirect.com/science/article/pii/S2197562026001120
#Sentinel1 #SAR衛星画像 #UNet #カーボンブックキーピングモデル #炭素フラックス #熱帯林攪乱 #アマゾン #ロンドニア州 #REDD #モンテカルロ不確実性解析 #Mapbiomas #地上部バイオマス炭素
CalFireSegNet: a lightweight hybrid attention–transformer network for post-wildfire building footprint change analysis using high-resolution satellite imagery
【どういう論文?】
・本論文は、カリフォルニアの山火事被災地を対象に、高解像度衛星画像から建物フットプリント(建物の輪郭形状)をセマンティックセグメンテーション(画像の各ピクセルが建物か背景かを塗り分けるAI技術)で抽出し、火災前後のマスク(塗り分け結果の白黒画像)の差分から建物損失領域を検出する軽量ハイブリッドモデル「CalFireSegNet」を提案する
・精度98.45%、mIoU(予測した建物形状と正解がどれだけ重なるかの指標)94.35%というトップクラスの性能を、代表的手法U-Netの約1/8のパラメータ数(3.72M)、1画像あたり11.8ms(84.7FPS=1秒に約85枚処理)という高速推論で実現した
【技術や方法のポイントはどこ?】
◾️先行研究の課題
①高精度なモデルほど計算量が重く、災害直後に使いにくい
・既存の建物損傷評価モデルは、高いセグメンテーション精度と引き換えにパラメータ数(モデルの重さの目安)や計算量が大きく、一刻を争う災害直後の展開に向かない
・大規模なVision Transformer系モデル(Swin-UNet、TransUNetなど)は40M〜80Mパラメータを超え、現場のエッジ端末(現地の小型コンピュータ)では動かしにくい
②局所の細部と広域の文脈を、軽量モデルで同時に捉えられない
・Attention機構(画像のどこに注目すべきかを学習する仕組み)やTransformer(画像全体の位置関係を一度に見渡す仕組み)は広域の文脈を捉える能力に優れるが、軽量な建物セグメンテーションモデルへの組み込みは限定的だった
・山火事後の地表は焼け跡 / 灰 / 影が混在するため、建物の輪郭(局所)と周囲との関係(広域)を両方見ないと誤検出が増える
③山火事の建物損傷ラベルがほとんど存在しない
・近年のカリフォルニア山火事では建物単位の損傷アノテーション(正解ラベル)がほぼ公開されておらず、教師あり学習による定量的な損傷評価ベンチマークを構築できない
◾️本研究のアプローチ
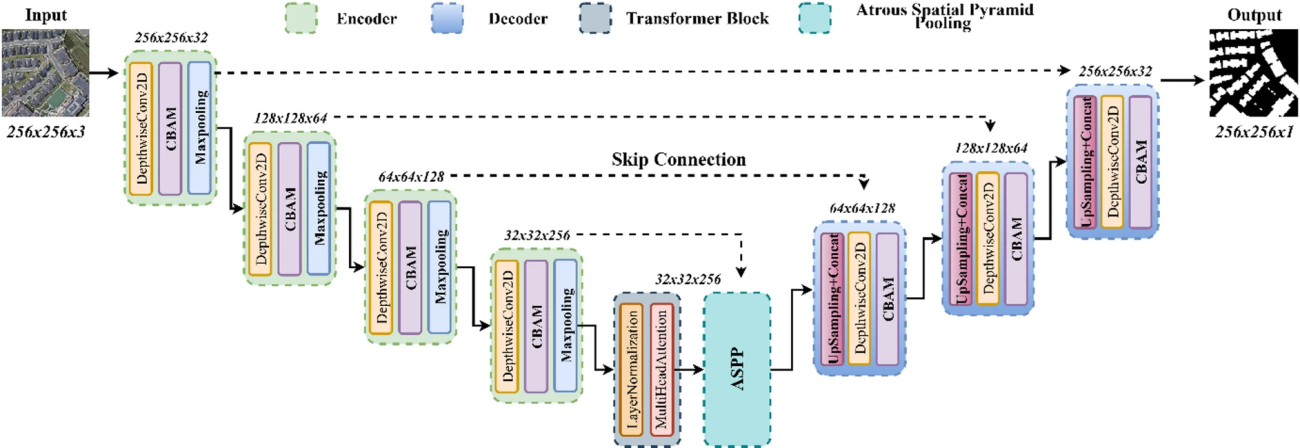
・DWConv、CBAM、ASPP、Transformerブロックという既存の4要素をエンコーダ・デコーダ構造(画像を段階的に縮小して特徴を捉え、元の解像度に戻しながら塗り分けを復元する構造)に統合する
・個々の要素は既知の技術だが、災害対応向けに軽量さと精度を両立させた設計を本研究の主眼とする
①DWConv + CBAMによる軽量な特徴抽出
・DWConv(Depthwise Convolution、深さ方向畳み込み)は、通常の畳み込みをチャンネルごとの処理と1×1畳み込みの2段階に分解し、パラメータ数と計算量を大幅に削減する
・CBAM(Convolutional Block Attention Module)は「どの特徴・どの領域に注目すべきか」をチャンネル方向と空間方向の2段階で重み付けする機構で、焼け跡や灰、影による偽陽性(建物でないものを建物と誤判定すること)を抑えつつ建物の構造的特徴を強調する
②ASPPによるマルチスケール文脈の統合
・ASPP(Atrous Spatial Pyramid Pooling)は、拡張率の異なる膨張畳み込み(フィルタの目を粗くして広い範囲を見る畳み込み)を並列に適用し、多スケールの文脈情報を1つの表現に統合する
③Transformerブロックによる長距離依存性のモデリング
・ASPPの出力を系列(シーケンス)に変換し、Multi-Head Attention(複数の視点から位置間の関係を同時に学習する仕組み)で画像内の全位置間の関係を学習する
④マスク差分による建物損失プロキシの生成
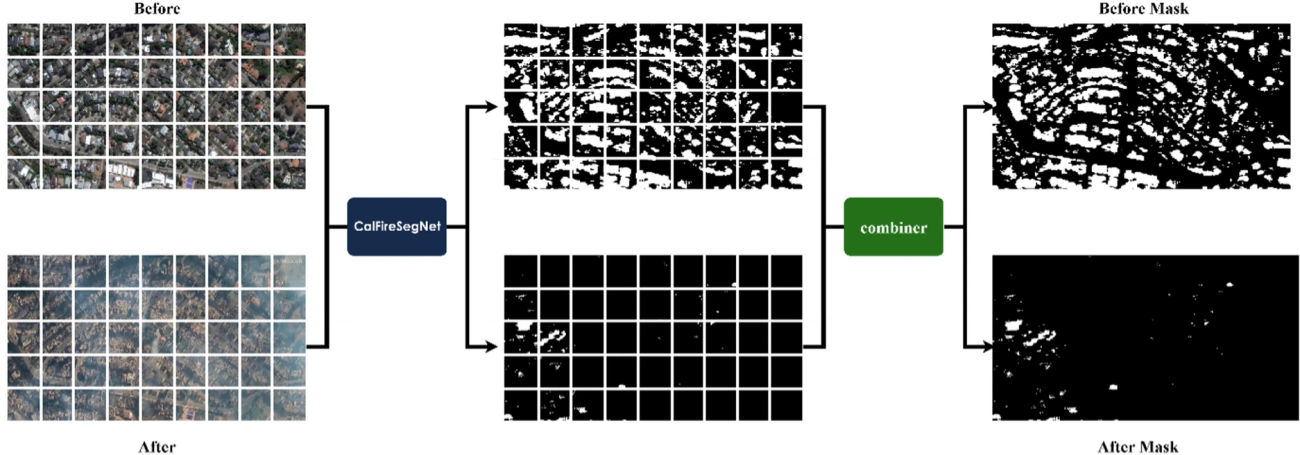
・火災前後の画像それぞれにモデルを適用して建物マスクを生成し、集合差分(Mpre \ Mpost=火災前にはあり火災後にない領域)を損失プロキシ(損失の代理指標)として抽出、差分マップでは消失領域を赤、過剰検出領域を緑で表示する
・この差分処理は追加の学習を必要としないため、ラベルの乏しい実際の被災地でも即座に適用でき、データが少ないという制約下でも初動の被害把握を可能にする
https://doi.org/10.1038/s41598-026-67452-7
◾️データセット
①Inria Aerial Image Labeling Dataset(世界10地域、360枚、810km²、地上分解能0.3m)・・・訓練 / 検証用ベンチマークとして、1024×1024パッチに分割後、256×256にリサイズして入力
②WHU Building Dataset(ニュージーランド・クライストチャーチ、22万棟以上、地上分解能0.075m。東アジアの衛星画像サブセット2.7mも含む)・・・訓練 / 検証用ベンチマークとして異なる解像度への対応を確認
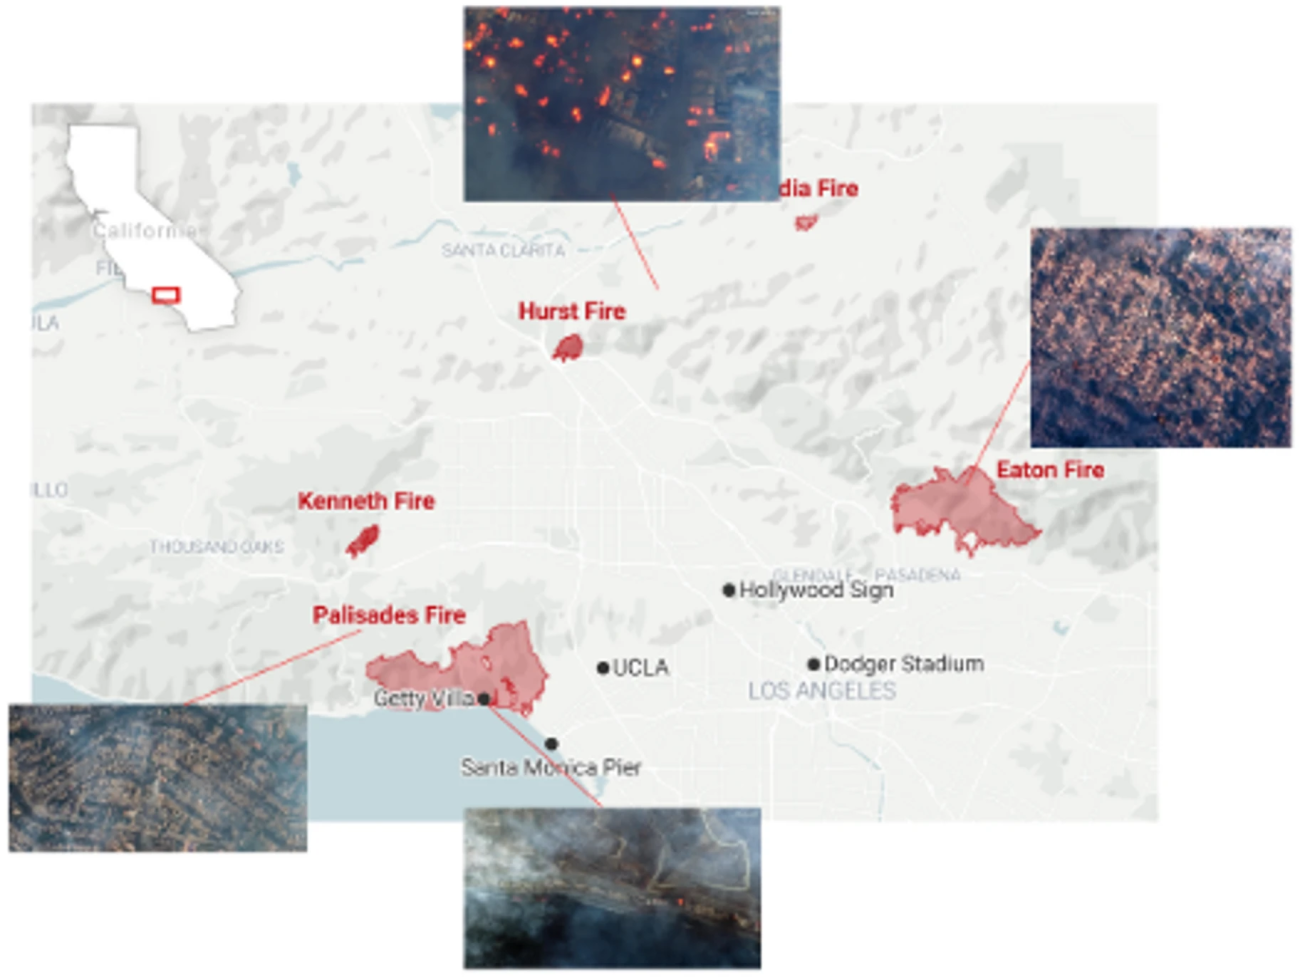
③California山火事衛星画像(Maxar Open Data Program、ロサンゼルス周辺4地区、火災前後8ペア、地上分解能0.3〜0.5m)・・・学習に一切使用していない実被災地での転移性能検証用
https://doi.org/10.1038/s41598-026-67452-7
【議論の内容・結果は?】
◾️検証結果の概要
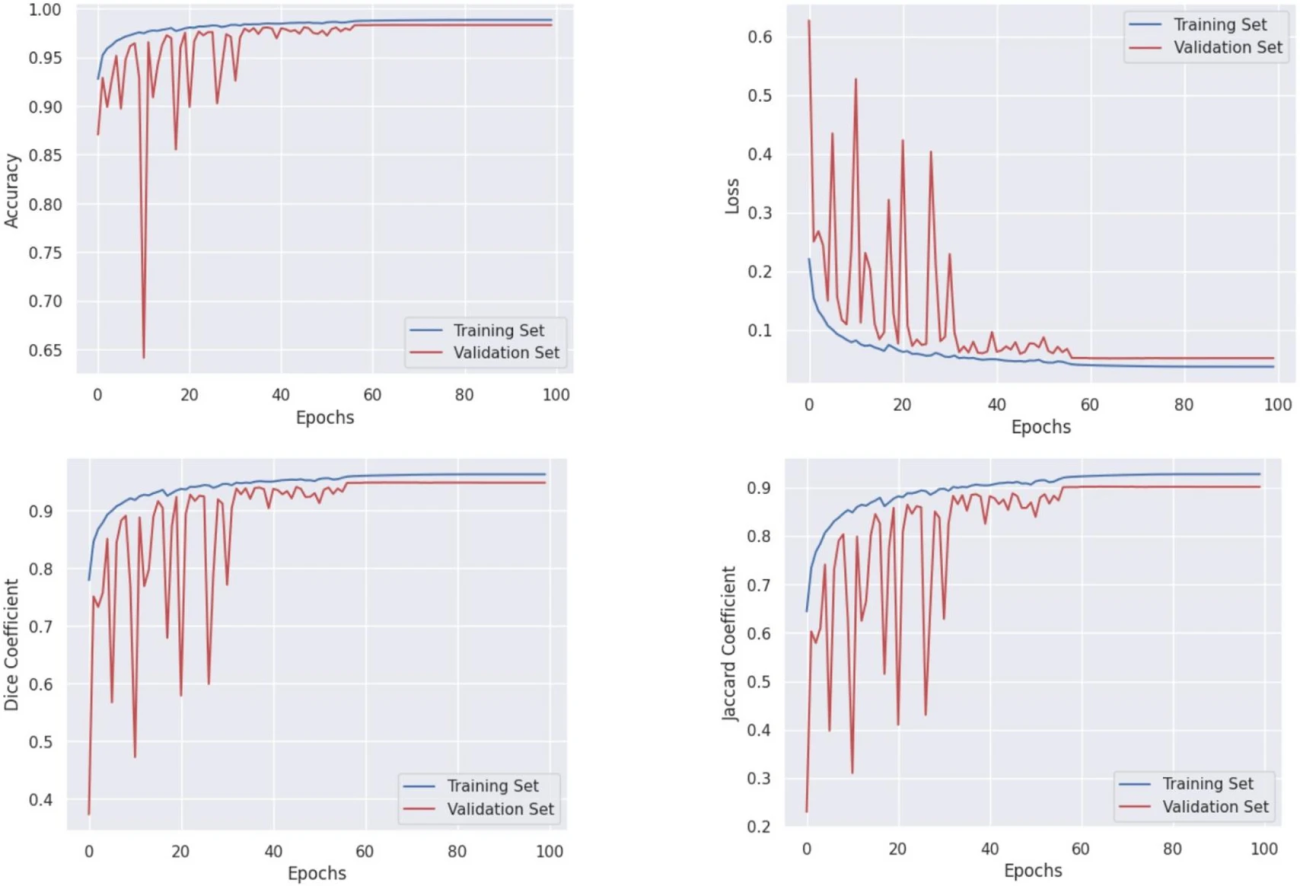
・CalFireSegNetは精度98.45% / mIoU 94.35% / DSS(mIoUと同様の重なり指標)95.03%を達成し、U-Net、PSPNet、DeepLabv3+、ENet、HRNet、SegNetの6モデルを上回った
・パラメータ数はU-Netの約1/8、推論速度は約3倍と、精度と軽量性を両立している
◾️詳細
①ベンチマークで比較6モデル中トップの精度
・精度98.45%、Precision(建物と判定したうち正解の割合)95.49%、Recall(実際の建物のうち検出できた割合)94.56%、mIoU 94.35%、DSS 95.03%
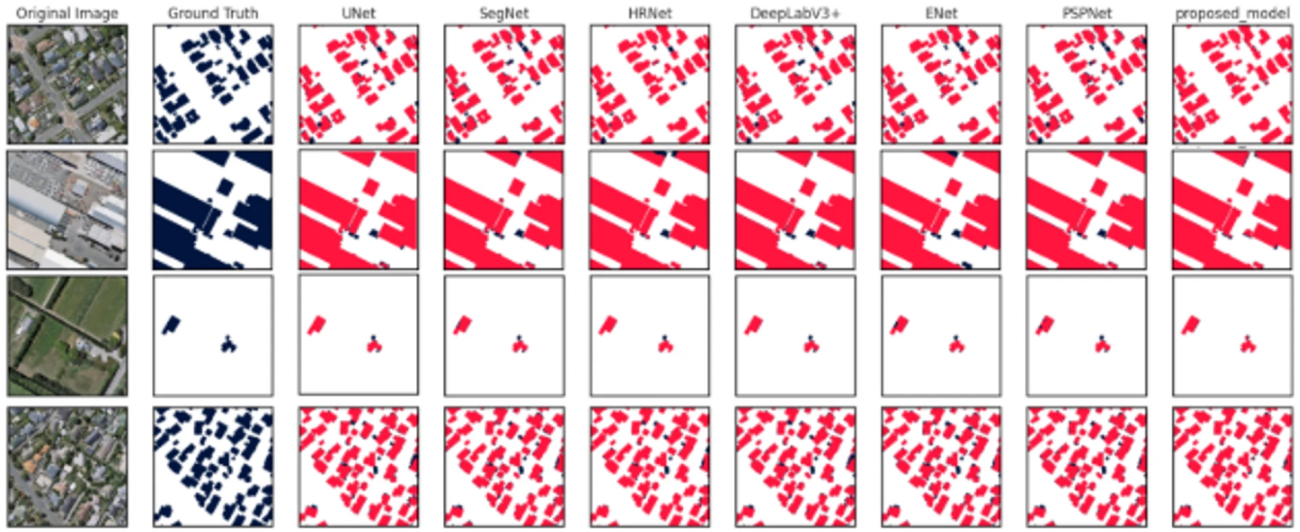
https://doi.org/10.1038/s41598-026-67452-7
②軽さと速さ
・U-Netの1/8のパラメータで3倍高速となった
※パラメータ数=3.72M(U-Net 31.05M、HRNet 28.60M)、計算量=9.82GFLOPs(1画像の処理に必要な演算回数の目安)
※推論latency=11.8ms/枚(84.7FPS、NVIDIA RTX 3090/T4環境)に対し、U-Net約34.2ms、HRNet約42.1ms
③実際の山火事被災地でも建物損失を可視化
・訓練に使用していないロサンゼルス周辺の被災地に対し、火災前後の建物マスク差分から建物損失プロキシマップを生成、専門家によるGround Truth(正解データ)と視覚的に精度高く対応した
※建物単位の定量ラベルが公開されていないため、著者らはこの検証を「教師ありベンチマーク」ではなく「クロスドメイン適用可能性の定性的検証」と位置づけている
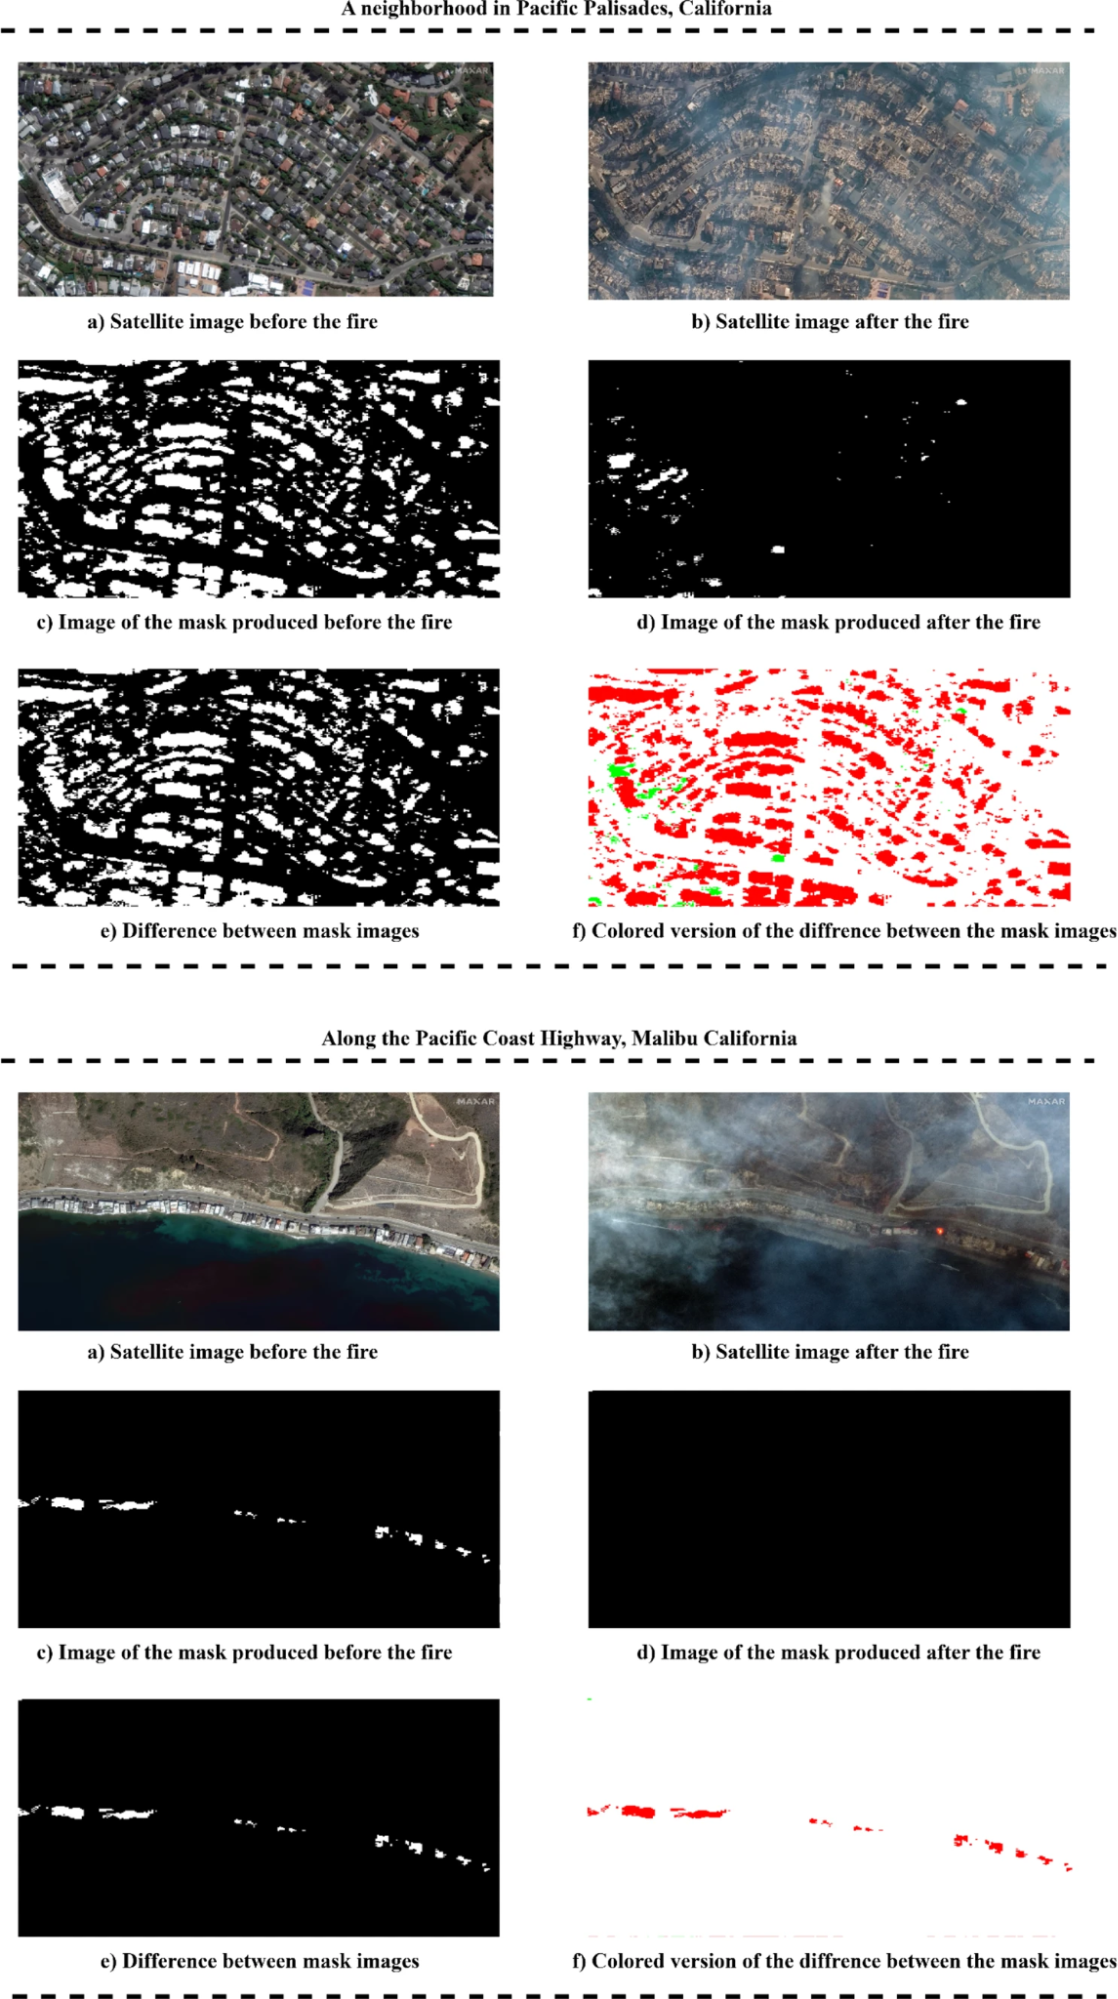
https://doi.org/10.1038/s41598-026-67452-7
#CalFireSegNet #CBAM #ASPP #Transformer #DepthwiseConvolution #建物フットプリント抽出 #山火事被害検出 #セマンティックセグメンテーション #Maxar衛星画像 #軽量モデル #変化検出 #災害対応 #リモートセンシング
CrisiSense-RAG: Crisis sensing multimodal retrieval-augmented generation for rapid disaster impact assessment
【どういう論文?】
・本論文は、ハリケーン・ハーヴェイ(2017年、米ヒューストン)を対象に、災害ピーク時のSNS投稿・緊急通報と数日後に撮られる航空画像という時間的にズレた情報を、そのズレを前提にして統合するマルチモーダルRAG「CrisiSense-RAG」を提案する
・追加学習なし(ゼロショット)で、ZIPコード(米国の郵便番号区域)単位の浸水範囲と建物被害率を推定し、テキストのみの推論より浸水範囲のMAE(平均絶対誤差、小さいほど良い)を最大8.62ポイント改善、被害推定では保険データで学習した専用モデル(MAE 11.3%)に匹敵するMAE 10.09%を達成した
【技術や方法のポイントはどこ?】
◾️先行研究の課題
①「速報」と「後日の写真」を同時刻の情報として扱ってしまう
・SNSや緊急通報は浸水ピーク時の状況を伝えるが、高解像度の航空・衛星画像は数時間〜数日後に取得され、水が引いた後の姿しか写っていない
・従来のナイーブな融合(各データの特徴を一つのベクトルに束ねる手法)はこの時間差を無視するため、晴れた事後画像がピーク時の信頼できる浸水報告を打ち消してしまい、最も重要な局面で被害を過小評価する危険があった
②災害ごとに大量の教師データが必要
・従来の被害推定AIは衛星画像かSNSテキストのどちらかに特化し、大規模なラベル付きデータで学習する必要がある
・新しい災害や新興SNSではそのデータが存在せず、即座に使えるモデルを作れない
③SNSの位置情報が使えない
・ジオタグ(投稿に付くGPS位置情報)が付いた投稿は1%未満で、座標ベースの絞り込みでは大半の投稿を捨てることになってしまう
◾️本研究のアプローチ
・ある郵便番号区域について関連する証拠を集め、Gemini・GPT-5-miniなどの汎用LLMに読ませて、浸水範囲と被害率を%で答えさせる(モデルの学習は一切行わない)
①証拠を集める
・郵便番号と期間を指定すると、その区域に関するツイート20件、311通報20件、雨量計3地点のピーク雨量、FEMAの過去損失額、航空画像6枚を自動で集めてくる
・ツイートはジオタグ(付いているのは1%未満)に頼らず、「I-610で浸水」「Bellaireで救助」のような地名を手がかりに意味検索で拾う
②LLMに2回、別々に答えさせる
・同じLLMに、まずテキスト証拠だけを渡して「浸水範囲○%、被害率○%、確信度」を出させ、次に航空画像だけを渡して同じ質問をする
③2つの答えを、時間差を踏まえたルールで合成する
[浸水範囲]
・テキストの答えを75〜80%、画像の答えを20〜25%の重みで平均する(画像は「3〜4日後の水が引いた状態」なので、常にテキストを優先する)
[被害率]
・画像で瓦礫や屋根の損傷が見えれば、テキストの答えに上乗せする(建物被害は水が引いても残るので、画像が信頼できる)
④答え方を指示で縛る
・LLMへのプロンプトに「画像は8月31日撮影で水は引いている。乾いて見えても浸水がなかった証拠ではない」と明記する
・「被害率」は「区域内の全建物の平均損傷割合」と定義して答えさせる(この指示がない場合、LLMは「悲惨なツイートが多い=90%」と印象で答えてしまう)
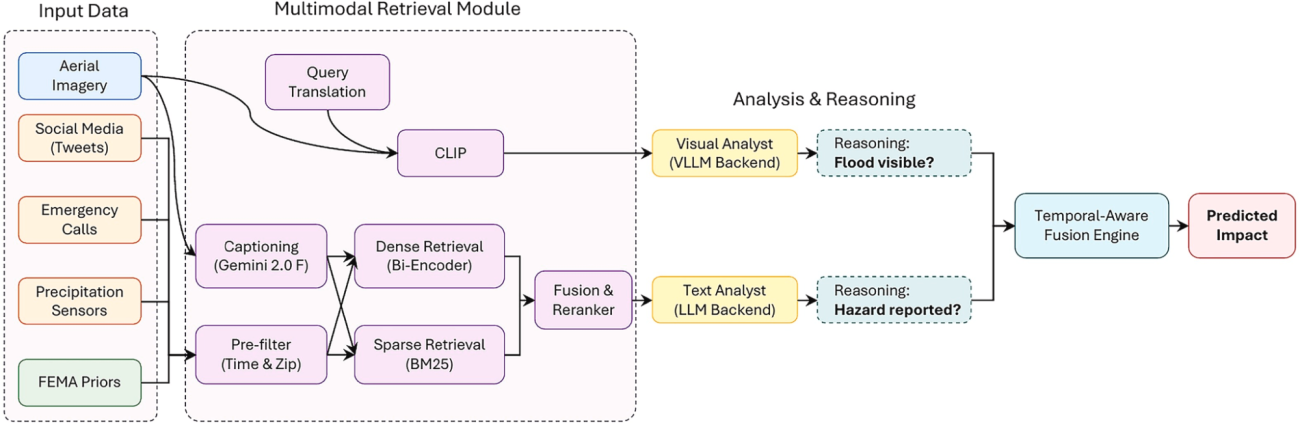
https://www.sciencedirect.com/science/article/pii/S1093968726030823
◾️データセット(5種類の異種データ)
①NOAA航空画像(3,507枚、0.5m解像度)
②ツイート(約2,400万件→フィルタ後458,453件)
③311緊急通報(26,107件、125ZIPコード)・・・建物レベルの浸水 / 被害を記録した公的データ、SNSが少ない地域の補完として利用
④降水量センサー(Harris County雨量計)・・・ZIPコードごとのピーク累積降水量を客観的な浸水指標として提供
⑤FEMA履歴損失データ(2010〜2016年)・・・地域の脆弱性を示す事前知識
◾️評価方法
・正解データとして、浸水範囲はFEMA(米連邦緊急事態管理庁)が作った浸水深マップから「区域面積の何%が水に浸かったか」を算出する
・被害率は先行研究(Ma et al., 2024)が建物ごとに推定した損傷割合(PDE)を区域内で平均した値とする
・評価指標のMAE(平均絶対誤差)とは、AIの答えと正解の差の絶対値を全区域で平均したものであり、たとえば「浸水範囲MAE 8.86%」は、正解が50%の区域に対してAIが平均して約41〜59%と答えている、というズレの大きさを意味する(0に近いほど良い)
【議論の内容・結果は?】
◾️検証結果の概要
・航空画像のある110ZIPコードで4種類のLLM(Gemini 2.5 Flash、Gemini 3 Flash、Qwen 3.5、GPT-5-mini)を評価し、学習なしで浸水範囲MAE 8.86〜19.64%、被害率MAE 10.14〜14.47%を達成した
・区域単位の初動判断には使える水準だが、個別の区域では30ポイント以上外す例もある
◾️詳細
①モデルを問わず一定の精度が出る
・浸水範囲はGPT-5-miniがMAE 8.86%で最良、被害率はGemini 3 FlashがMAE 10.14%(8.69〜11.61)で最良、最も悪いQwen 3.5でも浸水範囲MAE 19.64%となった
②航空画像が効くのは浸水範囲のみ、かつモデル次第
・画像を加えるとGPT-5-miniの浸水範囲のMAEは17.48%→8.86%(−8.62ポイント )、Qwen 3.5は22.06%→19.64%と改善した一方、Geminiはテキストのみで既に11〜13%に達しており、画像を足しても変化なしとなった
・被害率に関しては、4モデル中3モデルで画像を足すと悪化または横ばい、GPT-5-miniは11.14%→14.47%と3.3ポイント悪化した
③SNSを抜くと浸水推定だけが大きく悪化
・ツイートを除外すると4モデル全てで浸水範囲MAEが4.44〜7.46ポイント悪化(例: Gemini 3 Flash 11.11%→17.70%)、被害率MAEはほぼ変化なしとなった
・つまり、SNSは浸水範囲の主情報源、一方で311通報 / FEMA履歴は被害率の主情報源という役割分担を確認できた
#マルチモーダルRAG #検索拡張生成 #災害被害評価 #ハリケーンハーヴェイ #CLIP #ハイブリッド検索 #航空画像 #SNS解析 #ゼロショット #時間的非同期融合 #防災AI
TOWARDS A SATELLITE IMAGE MANIPULATION AND DEEPFAKE LOCALIZATION BENCHMARK DATASET
【どういう論文?】
・本論文は、生成AIによる衛星画像の改ざん・ディープフェイクを対象に、改ざん領域を示す正解マスク(ground truth mask、どのピクセルが偽物かを示す答え合わせ用の地図)と地理参照 / 取得メタデータを備えたベンチマークデータセット「fmow-fake-small」(改ざん30枚+本物30枚、計60枚)を提案する
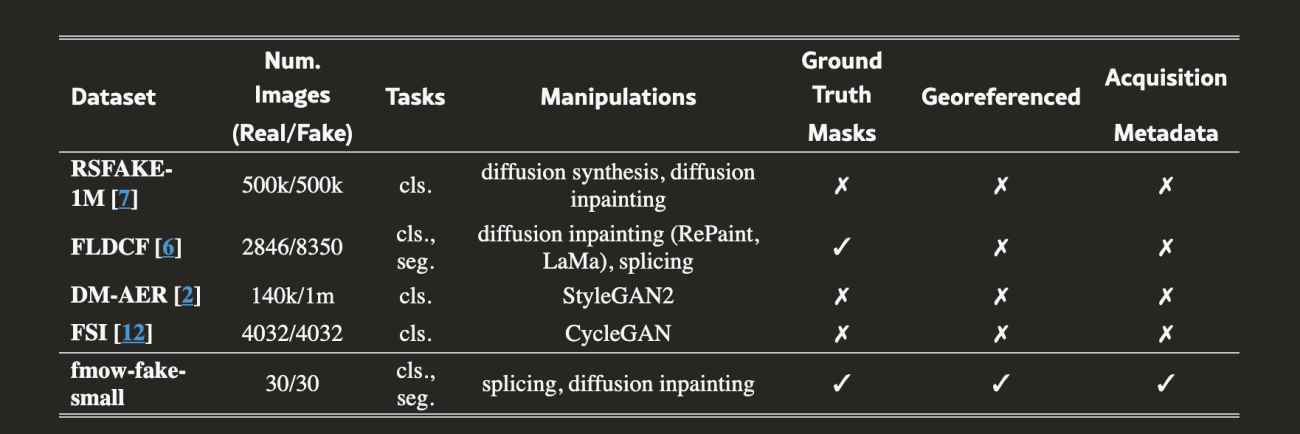
・既存の主要4データセットがの多くが「本物か偽物か」の分類しか評価できず、改ざん領域の正解マスクを備えるものも地理参照や取得メタデータを欠いていたのに対し、改ざん領域の局所化(localization、画像のどこが偽物かをピクセル単位で特定すること)の評価に必要な正解マスク・地理参照・取得メタデータをすべて備えた 唯一のリモートセンシング向けデータセットである
【技術や方法のポイントはどこ?】
◾️先行研究の課題
①偽物かどうかは分かってもどこが偽物かを採点できない
・RSFAKE-1M、DM-AER、FSIなどの既存データセットは分類ラベルしか持たず、改ざん領域を示す正解マスクがない
・検出器がピクセル単位でどこまで正確に偽の領域を特定できるか(局所化性能)を評価する手段がなかった
②偽画像の質が古く、一目で見破れてしまう
・DM-AERはStyleGAN2、FSIはCycleGANといった旧世代のGAN(敵対的生成ネットワーク)で生成されており、最新の拡散モデル(diffusion model)が作る精巧な偽画像とは質が大きく異なる
◾️本研究のアプローチ
・fMoW(WorldView-2/3 / GeoEye- / QuickBird-2で撮影された約200カ国・100万枚超の高解像度衛星画像データセット)を土台に、難易度の異なる3種類の改ざんを施し、すべてに正解マスクと取得メタデータを付与する
①Simple Splice(単純スプライス)
・別画像(source image)からランダムに切り出した矩形領域をそのままベース画像へ貼り付ける、コラージュ的な改ざん
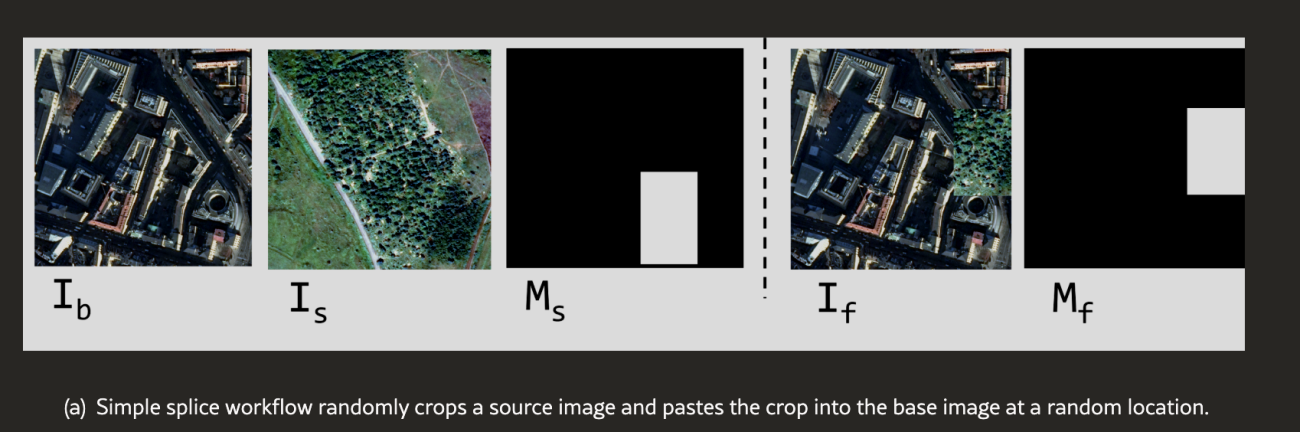
https://https://arxiv.org/html/2608.04840v1
②Object Splice(物体スプライス)
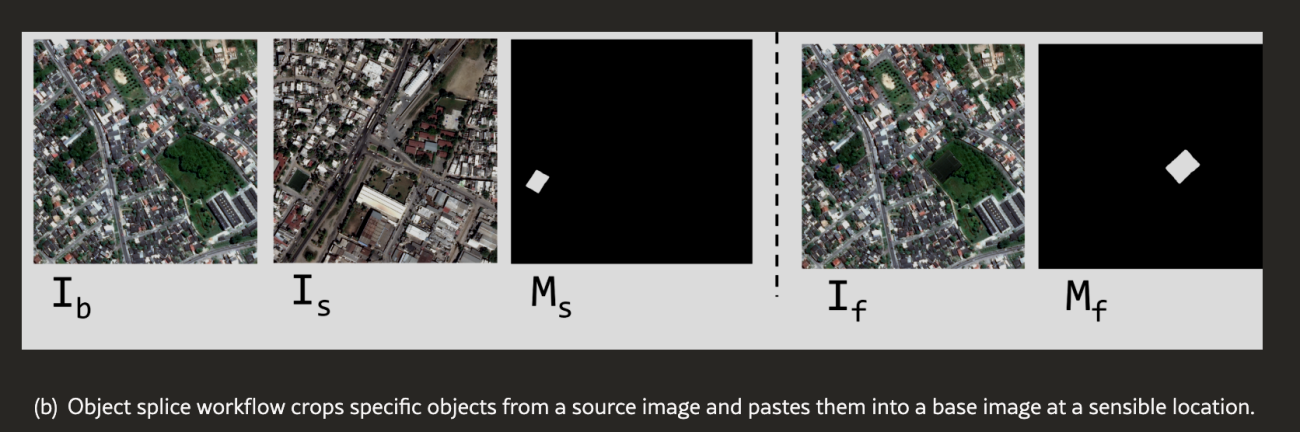
・SAM(画像内の物体の輪郭を自動で切り出すセグメンテーションモデル)でソース画像から車・プール・建物・ランウェイなどの物体や地表面を抽出し、人手でマスクを精査して妥当な位置にベース画像へ貼る
https://arxiv.org/html/2608.04840v1
③Diffusion Model Inpainting(拡散モデルによるインペインティング)
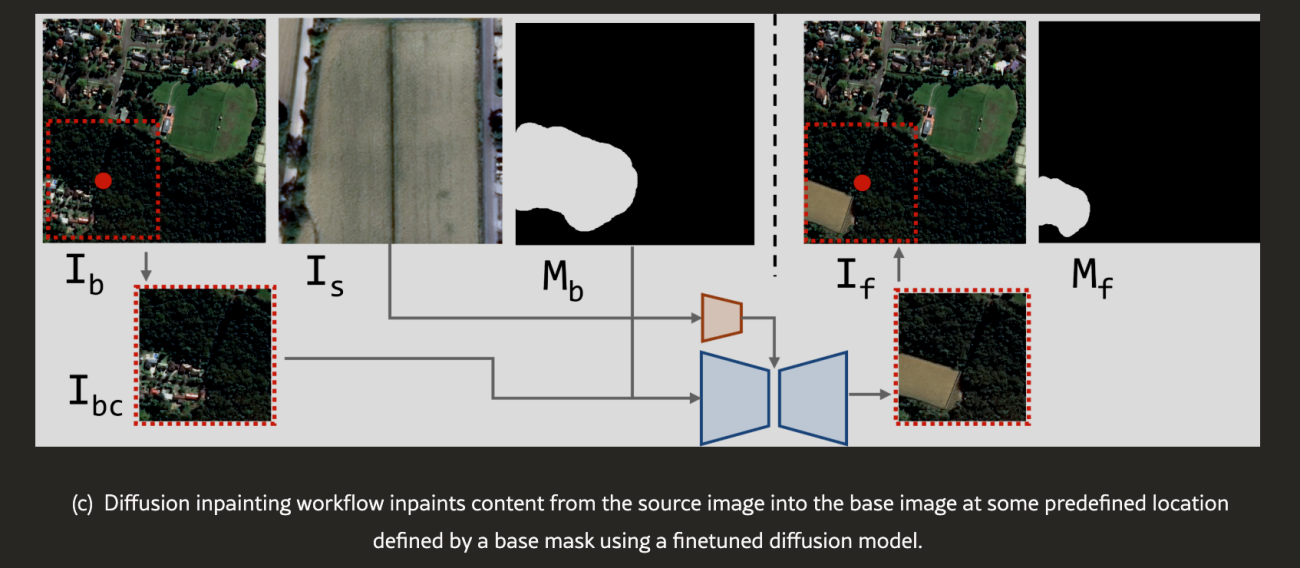
・RSPaint(Stable DiffusionをSAMRSデータセットでpaint-by-example方式によりファインチューニングしたモデル)で、ソース画像の物体をベース画像のマスク指定領域へexemplar-based(見本画像を参照して描き込む方式)に生成する
https://arxiv.org/html/2608.04840v1
◾️データセット
・fMoW(本物の衛星画像)・・・WorldView-2/3 / GeoEye-1 / QuickBird-2という商用衛星で撮影された、約200カ国・100万枚超の高解像度(0.31〜1m/ピクセル、車1台が見える細かさ)衛星画像集
【議論の内容・結果は?】
・既存の主要4データセットのうち、正解マスク / 地理参照 / 撮影条件記録の3つをすべて備えるのはfmow-fake-smallのみで、見た目としては既存データセットに残る明白な痕跡がない偽画像を実現した
・一方で規模は60枚と既存の1/50〜1/17,000の規模となっているため、著者としても「学習用ではなく評価用」と位置づけている
・また、今回は検出器を1つも走らせていないため、「このデータセットは実際にどれくらい難しいのか」が分からない
・加えて、60枚は、検出器の性能をサイズ別 / 種類別に統計的に比較するには少なすぎる上(Simple Spliceの16×16サイズは2枚しかない)、生成AIを用いた改竄はDiffusion Inpaintingの1種類のみで、モデルもRSPaint 1つとなっているので最新の生成AI全般に通用するかという点は測れず、Object SpliceとInpaintingは物体の選定・配置が人手のため量産できない状況になっている
#ディープフェイク検出 #画像フォレンジック #衛星画像改ざん検出 #fMoW #SegmentAnythingModel #拡散モデルインペインティング #RSPaint #正解マスク #局所化評価 #ベンチマークデータセット
来月も「#MonthlySatDataNews」「#衛星論文」を更新しますので、お楽しみに!